Reader 外壳里的可编程 monitoring workbench↗
Inoreader 的核心不是替用户决定什么重要,而是让 power user 对 ingestion、query、filter、rule、save 与 distribution 拥有细粒度控制。RSS、newsletter、网页变化、社交来源和文件都被折叠成近似统一的 article/feed 对象。
 123
Saved query 变成一等 feed↗
Monitoring Feed 可以只搜索已订阅内容,也可以从 Inoreader 的公共 source corpus 中发现匹配文章。创建后它和普通 feed 一样进入 folder、rules、search、RSS export 与 HTML clip。这是非常关键的抽象:query 不再是一次搜索,而是一个持续更新的对象。
先过滤和路由,再调用 AI↗
Rules 可以基于来源、关键词、作者与其他条件打标签、保存、通知、转发、翻译或触发摘要。与纯 LLM-first 产品不同,Inoreader 允许确定性规则承担大量便宜、可解释的前置工作,AI 只处理需要 synthesis 的集合。
Rule 的价值不只是省 token,而是可解释、可回放:某篇文章因为哪个字段、哪个条件被加 tag、发送邮件或推入 webhook,可以被管理员审计。LLM 更适合处理规则无法穷举的语义判断,但不应替代所有 routing。可靠设计是先让 query、filter 和 rule 处理可确定部分,再把缩小后的集合交给模型。
多篇分析的输出仍然是一篇可操作 article↗
2026 年的 Automated Intelligence Reports 可以按计划从 feed、folder、tag 或 Team channel 取材,用预设或自定义 prompt 做比较、情绪分析、趋势识别和结构化研究。结果被保存成新的 article,可继续标注、搜索、分享和导出。
这个设计把生成式输出重新送回原有知识流,而不是留在独立 chat 历史中。
自动报告生成后会进入 Inoreader,表现得像一篇文章,因此还能被收藏、标注、搜索、分享或触发下一条 Rule。这比一次性 chat response 更重要:AI 输出重新进入原有信息系统,拥有时间、来源范围和归档位置。团队应同时保留生成时使用的 query、source set 与模型配置,否则后续很难解释两期报告为什么不同。
低价 Pro 承载高密度个人工作流↗
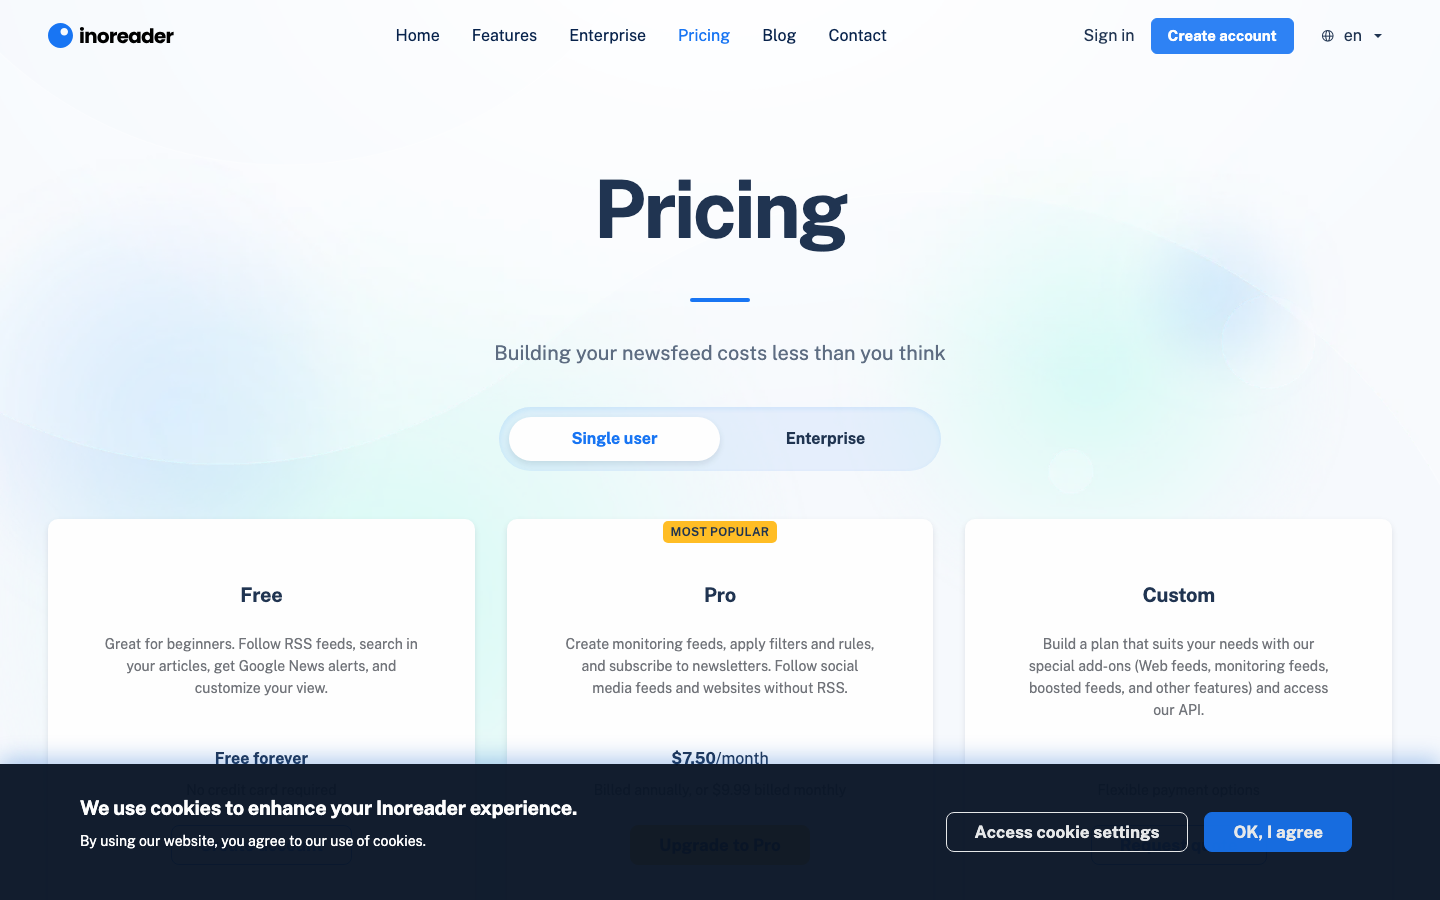
Pro 年付折合 $7.50/月,包含 2,500 RSS subscriptions、20 web feeds、20 newsletter feeds、30 monitoring feeds 与 rules/filters。Intelligence Reports 对 Pro/Custom 是 add-on,在 Team Intelligence 中包含。
公司、团队与资本:先确认是谁在经营↗
产品由保加利亚 INNOLOGICA OOD 运营(EIK 202279697,2012-10-22 注册)。登记资料显示 Ivo Djokov、Yordan Yordanov、Nikola Kostadinov、Andrey Lyubenov 持股;公司同时承接其他技术业务,因此公司报表不等于 Inoreader 产品报表。
FIRST-PARTY / REGISTRY · INNOLOGICA registry-derived financials ↗
登记聚合数据给出约 10 名员工;这与长期、小团队、高自动化的产品形态相符,但不是完整组织图。2018 官方 deck 曾披露 200K MAU、10K+ premium、60 VMs / 14 hosts;只能标为历史快照。
FIRST-PARTY / PLATFORM SIGNAL · INNOLOGICA registry-derived financials ↗ · Inoreader 2018 company deck ↗
没有找到风险投资记录。欧盟资助项目预算 BGN701,200 属于 INNOLOGICA 的另一项目,不应冒充 Inoreader 融资。公开证据更接近以客户现金流长期经营。
DISCLOSURE / UNKNOWN BOUNDARY · INNOLOGICA registry-derived financials ↗
能证明什么,不能证明什么↗
收入结论:公司登记聚合页显示 2020 turnover BGN2.205M、profit BGN898K,约 40.7% 会计利润率;2024 revenue +34.6%、profit +53.4%、EBITDA +55.2%。这些是 INNOLOGICA 总体财务,不是产品 ARR,但足以证明它不是靠融资维持的 demo。
DISCLOSED / UNKNOWN / SCENARIO · INNOLOGICA registry-derived financials ↗
可验证 traction:历史官方数据证明 2018 年已达到百万注册、20 万 MAU、1 万付费;不可当成 2026 当前数据。2025 年公司把翻译和 TTS 迁到自有硬件,是持续规模和成本优化的经营信号。
PLATFORM / FIRST-PARTY SIGNAL · Inoreader 2018 company deck ↗ · In-house TTS and translation infrastructure ↗
G2 当前只有约 19 条 review,样本太小,不能代表全部客户;它至少提供 vendor 之外的 power-user 反馈面。页面因此只把它用于检查 workflow friction,不用来证明市场份额或收入。
INDEPENDENT / PLATFORM SIGNAL · G2 review corpus ↗
收费模型:免费层承担习惯与口碑,Pro 为 $89.99/年或 $9.99/月;Custom/Team、Intelligence Reports add-on 和企业合同提升 ARPU。它把昂贵 AI 放在 rules、filter、tag 之后,允许用户自带模型 key,成本控制比全量 LLM-first 更清晰。
CURRENT PUBLIC PRICING · Inoreader pricing ↗
价格背后的成本与可持续性↗
抓取 15M+ feeds 的队列与存储、全文与网页监控、搜索索引、规则执行、邮件/推送、翻译/TTS、团队权限和 support。先用确定性规则缩小 corpus,再生成 report,是其利润结构的重要产品选择。
三个假设,以及怎样证明我们错了↗
以下不是一句‘值得做/不要做’的结论,而是三个可以被证伪的方向。任何一个 kill test 命中,都应停止为原叙事寻找借口。
把最重要的产品承诺放到失败路径里↗
同一 objective、同一 20 个公开 sources、5 个故意含‘Amazon jobs’的 false-positive feeds,以及一条会重复发布的 PR wire。
按公开 automation 与 Intelligence Report surface 重建 Monitoring Feed → Rule → tag → report;检查哪些步骤是 deterministic、哪些进入 LLM,并用当前 pricing/limits 计算持续执行成本。
Monitoring query、rule、tag、dedup、report 与重新保存为 article 的链条在公开产品材料中逐步可见;可以把 jobs 先排除再交给 AI。公开 surface 不提供这组 fixture 的实际 recall、false-positive rate 或 report citation export。
若用户漏写排除规则,系统会稳定地产生高精度格式、低精度内容;workbench 的透明度不会替用户定义 relevance。
Inoreader 胜在可审计管线与成本顺序,弱点是配置劳动。新机会必须自动生成规则并解释每条规则,而不是再造低价 workbench。
同一任务:Inoreader 与 Feedly 的证据边界↗
追踪 Amazon 在 AI developer tools 上的 product launch 与 partnership,每周产出一份可追溯 briefing。
| Same job / public evidence | Inoreader | Feedly | Decision boundary |
|---|---|---|---|
| 目标表达 | query + rule + tag,用户显式配置 | entity + AI Model + natural-language intent | Feedly 更早把 ontology 放进筛选 |
| 相同 false positives | 可用 NOT/condition 手工排除 | entity/concept model 自动减少歧义 | Inoreader 更透明;Feedly 更省配置 |
| 输出 | scheduled Intelligence Report → article | Ask AI / report / newsletter / API | 都可交付;Feedly 更贴近 enterprise analyst |
| 公开价格 | $89.99/年 + add-on/Team | $1,600–2,400/月 | 价差对应 ontology、corpus、sales 与治理,而非只多一个 summary |
| 可验证缺口 | 未公开本 fixture recall | 未公开本 fixture recall | 不能用 feature list 宣称谁更准确 |
控制力强,设置成本也由用户承担↗
Feedly 试图用 ontology 在收集前提升 relevance;Inoreader 更像先给足 ingestion 与 automation,再由用户设计筛选和分析。优势是透明、灵活、price/value 高;代价是 source discovery、重要性定义与跨时间 event memory 仍主要由用户维护。
当 folder、tag、filter、rule、monitoring feed、dashboard 与 report 都可自由组合时,同一个业务目标可能出现多套重叠配置。维护者离开后,团队常不知道哪些规则仍在使用。企业化不仅需要更多功能,还需要 owner、last run、命中量、异常率、变更记录和停用建议,才能把个人 power-user 配置变成稳定的组织系统。
统一 ingestion 让规则可以跨来源复用↗
RSS、newsletter、web feed、monitoring result 和其他内容最终都进入相似的 article/feed 模型。这样同一套 folder、tag、search、rule、export 与 Team channel 可以覆盖不同输入,不必为每个 connector 重做 workflow。
Monitoring Feed 是一条会继续运行的 saved query↗
普通搜索回答“现在有什么”;Monitoring Feed 回答“以后出现什么都告诉我”。它可以限定在已有 subscriptions,也可以使用 Inoreader 的公共 source corpus,再像普通 feed 一样进入 folder、rules、RSS export 和 HTML clip。
这个抽象比 AI 摘要更重要,因为它把 intent 变成可调试、可组合、可长期运行的对象。
把竞争对手 pricing change 变成每周报告↗
先用 web feeds 与 Monitoring Feeds 捕获 competitor、pricing、plan、enterprise 等变化;Rules 排除招聘和促销,给 product launch、partnership、funding 打不同 tag;Automated Report 每周只读取这些 tag,输出变化、证据与影响。
确定性前置过滤降低成本,也使漏报原因更容易定位。
规则负责可解释,AI 负责难以写成规则的 synthesis↗
用户能看到哪些关键词、source 和 rule 让文章进入报告;生成层则适合比较、归纳和提取趋势。两层分开后,错误可以被定位为采集遗漏、规则错误或模型判断,而不是一个无法解释的黑箱分数。
2013 Reader → 2015 Rules → 2025 Intelligence → 2026 automated research↗
Inoreader 2013 年成立时就把“用户控制 newsfeed”作为核心。2015 年公开的 Rules 已经具备 incoming article、条件匹配与自动 action;这说明 automation 不是为了赶 AI 风口临时加上的模块。之后产品逐步加入 web feeds、track changes、newsletter feeds、social sources、global search、Teams 与 API。
2025 年 Intelligence 把单篇问答、自定义 prompt 和报告嵌入原有内容库;2026 年又加入 automated reports、AI-assisted Boolean builder、多 provider/BYOK 与共享 Team dashboards。演进路线一直围绕同一件事:把更多信息处理动作变成可持续配置。
公共 source corpus 与长期存储,让 Monitoring Feed 不只是关键词提醒↗
Global Search 可以在用户订阅之外的 publicly available sources 中找文章,并把结果保存成持续更新的 Monitoring Feed。普通 RSS 只携带有限近期 items;云端 reader 长期抓取后形成的历史库,使之后加入的用户也可能搜索到更早内容。
但“平台抓到过”与“完整历史”不是同一回事:source 何时首次进入 corpus、publisher 是否删除内容、付费墙与 robots/policy 都会影响 recall。页面应该把它描述为有价值的 shared corpus,而不是没有边界的 web index。
Provider choice 与 BYOK 把模型成本从产品价值中拆开↗
2026 年 Intelligence 可选择 OpenAI、Mistral 或 Anthropic,也允许连接自己的 API key 与模型。这样团队可以根据数据政策、价格和性能选择 provider;Inoreader 的价值更多落在 corpus selection、rules、report scheduling 与 output integration,而不是绑定某一个 LLM。
Intelligence 使用独立 token quota/add-on。最经济的 pipeline 是让 filters、duplicate detection 和 rules 先缩小集合,再对明确的 tag、folder 或 monitoring feed 生成报告,而不是让 LLM 阅读整个 inbox。
共享的不是聊天记录,而是 corpus、规则、dashboard 与报告↗
2026 Team 更新把 member/billing/SSO/API key、shared folders、channels、tags、filters、uploads、dashboards 与 Intelligence reports 放进同一个管理面。管理员能观察共享 sources,成员能使用共同 corpus;自动报告还能直接成为团队文章和后续 rule trigger。
这比把一封 AI 摘要转发到 Slack 更接近组织记忆,但仍需要明确 ownership:谁维护 source、谁批准 filter、谁解释遗漏、旧 report 保留多久,以及个人规则与 Team rules 如何冲突。
比 Feedly 更可编程、更便宜;比 Folo 更像 workbench;比 Daigest 更重↗
Feedly 把 ontology 和预训练 AI Models 放在 relevance 之前,适合高预算 analyst;Inoreader 把 query、rule、tag 和 report 交给用户,透明且灵活。Folo 的 consumption/discovery 更现代,Inoreader 的 monitoring/automation 更深。Daigest 直接交付 briefing,Inoreader 则保留完整 inbox、library 和配置面,因此能力更广、time-to-value 也更慢。
不要再做一个需要用户手工堆 Boolean、folder 和 rule 的横向 workbench;Inoreader 已经用十多年积累把这条路做得很深。更有空间的是把业务目标自动编译成可检查的 monitoring plan:系统提议 sources、query 与规则,解释每一步会漏什么,并让专家只负责校正。这样复用了它证明有效的确定性底座,却把设置成本从用户转回产品。
先建立 cheap deterministic pipeline,再使用 LLM↗
Inoreader 最值得学习的不是 feature 数量,而是成本结构:能用 filter、dedup、rule 解决的问题不交给模型;需要跨篇语义判断时才调用 AI。生成结果重新成为 article,也让现有搜索、标签和分享能力继续复用。
把配置负担变成 AI-native setup↗
Inoreader 的强大也制造了机会:用户仍要理解 query、folder、tag 和 rule。新的产品可以让用户只描述 objective,再自动提出 source plan、生成规则、展示为何命中,并在运行中用反馈校准,而不是要求用户先成为信息架构师。