不是替你读,而是让阅读进入长期记忆系统↗
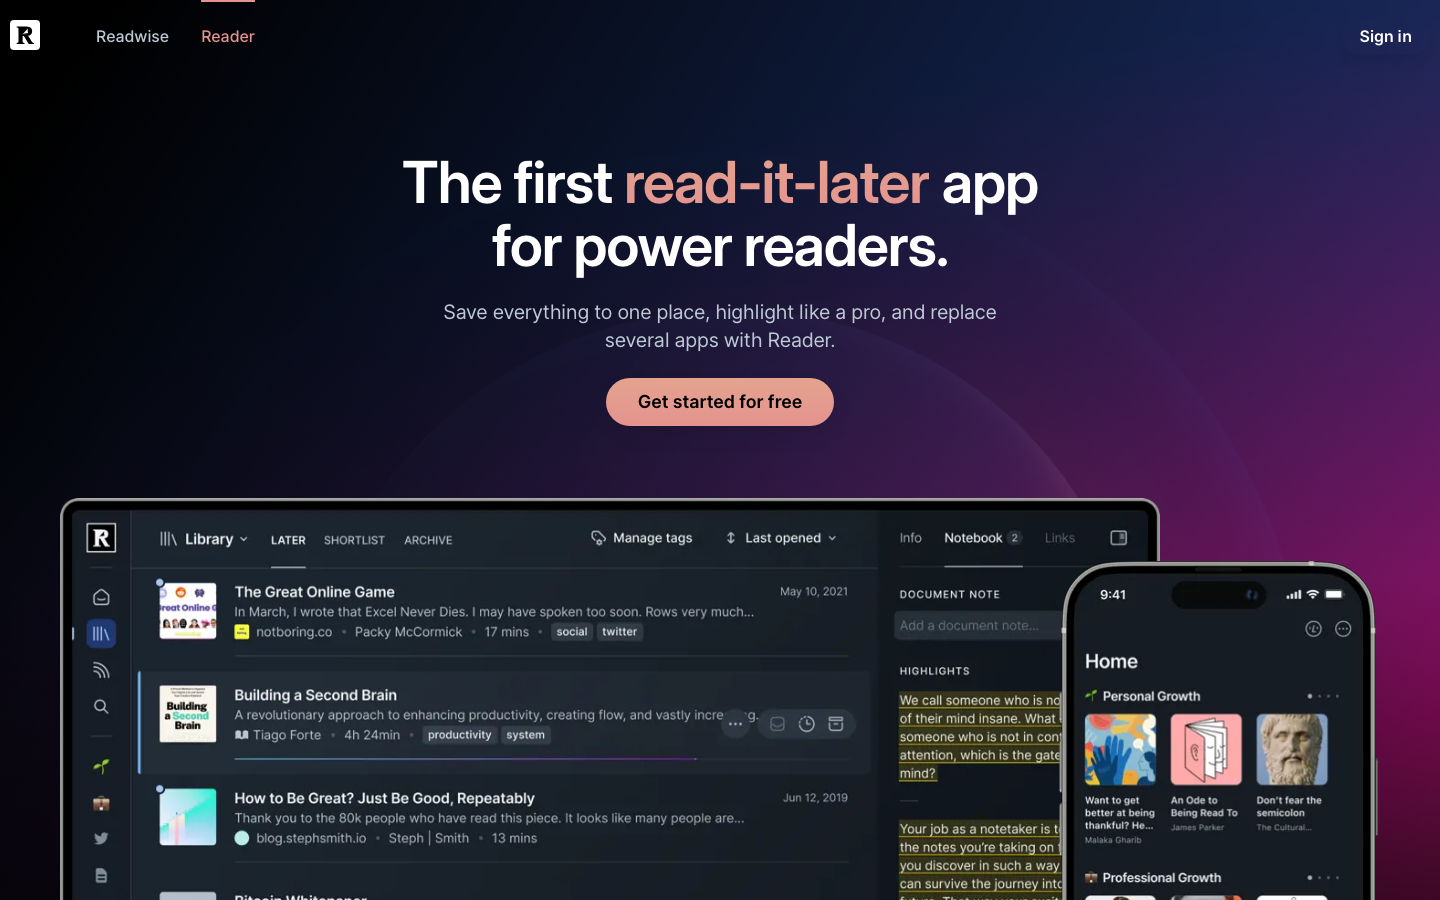
Readwise Reader 把 article、newsletter、RSS、PDF、EPUB、video 与 social post 放进统一 Library。用户仍然阅读,但 parser、offline cache、highlight、note、review 与 PKM export 把一次消费变成可积累的知识对象。
 123
Document、Highlight、Note 与 View↗
Reader 的中心对象是 Document。Highlight 和 note 挂在原文位置上,filtered view 负责组织状态与主题;Feed 里的内容只有在用户决定保存后才进入长期 Library。这个边界避免所有订阅内容无差别污染知识库。
网页、newsletter、PDF、EPUB、YouTube transcript 与 RSS item 最后都成为 document,并共享 Inbox/Later/Archive、location、highlight、note、tag 与 reading progress。这个统一对象让移动端标注、桌面整理、Daily Review 和 PKM export 连成一条链。格式解析只是入口,长期价值来自稳定 ID 与跨 surface 状态。
AI 被限制在当前 document 或 selection 的语境内↗
Ghostreader 已进入统一 Chat sidebar,可对全文或选中文本总结、解释、翻译、查词、提出问题、生成 newsletter blurb,并进行追问。回答能引用文档位置,并保存进 document note 或 highlight note。
不是几个按钮,而是一套可编程阅读语法↗
自定义 prompt 支持 document metadata、content、summary、tags、notes、highlights,以及 lexical search、semantic similarity、central paragraphs、classification 等 subroutines。Jinja 风格变量与条件允许不同文档类型走不同处理路径。
Read → Highlight → Review → Export↗
真正的防御力来自 Readwise 已有的 highlight library、Daily Review、阅读习惯与 Notion/Obsidian 等 integrations。AI 输出不是一次性 chat,而可以进入复习和写作素材库。
普通 Reader 只知道打开、停留和收藏;Readwise 还知道用户具体划了哪一句、写了什么 note、后来是否复习或导出。这些信号可以帮助理解真正重要的概念,但默认不应被偷偷变成推荐画像。更可信的设计是让用户明确选择哪些标注可用于 Ghostreader context 或未来的 relevance model。
公司、团队与资本:先确认是谁在经营↗
Readwise, Inc. 运营 Readwise 与 Reader。公司由 Daniel Doyon、Tristan Homsi 等创立,2018 年曾接近融资,随后明确选择 self-funded 路径;官方招聘材料称公司 sustainable、profitable,并服务 tens of thousands of customers。
FIRST-PARTY / REGISTRY · Readwise careers / operating model ↗ · Why Readwise did not raise VC ↗
官方 2026 招聘材料给出约 20 人、9 名工程师。Reader 不是独立初创,而是建立在 Readwise 多年用户、highlight 数据和 Daily Review 习惯上的第二产品面。20TB+ Postgres 说明长期资料库已经成为真实的运维资产。
FIRST-PARTY / PLATFORM SIGNAL · Readwise careers / operating model ↗
没有外部融资;这是公司自己明确表述的选择,而非根据‘没查到融资’推断。盈利订阅现金流承担 Reader 的多年开发,使其可以牺牲短期发布速度换 parsing、offline、sync 与迁移完整性。
DISCLOSURE / UNKNOWN BOUNDARY · Why Readwise did not raise VC ↗
能证明什么,不能证明什么↗
收入结论:未披露 ARR。基于 20 人盈利运营、约 $120 年价和‘数万客户’,可以说 multi-million-dollar recurring business;$4M–$15M 仅是宽泛 operating-consistency band,不是管理层数字或第三方点估计。
DISCLOSED / UNKNOWN / SCENARIO · Readwise careers / operating model ↗
可验证 traction:官方只披露 tens of thousands customers;Android Reader 为 100K+ downloads,但 download 不是 payer。团队规模、盈利状态、持续招聘和 20TB 数据库共同提供强于 app rating 的经营一致性证据。
PLATFORM / FIRST-PARTY SIGNAL · Readwise careers / operating model ↗ · Reader Android distribution ↗
两篇独立 hands-on review 都把 capture → highlight → review/export 视为主要价值,而不是单次 AI summary;Reddit 同时出现 metadata、启动速度与开发节奏抱怨。它们是自选用户样本,用来暴露 friction,不用来外推 churn。
INDEPENDENT / PLATFORM SIGNAL · Developer workflow review ↗ · Independent productivity review ↗
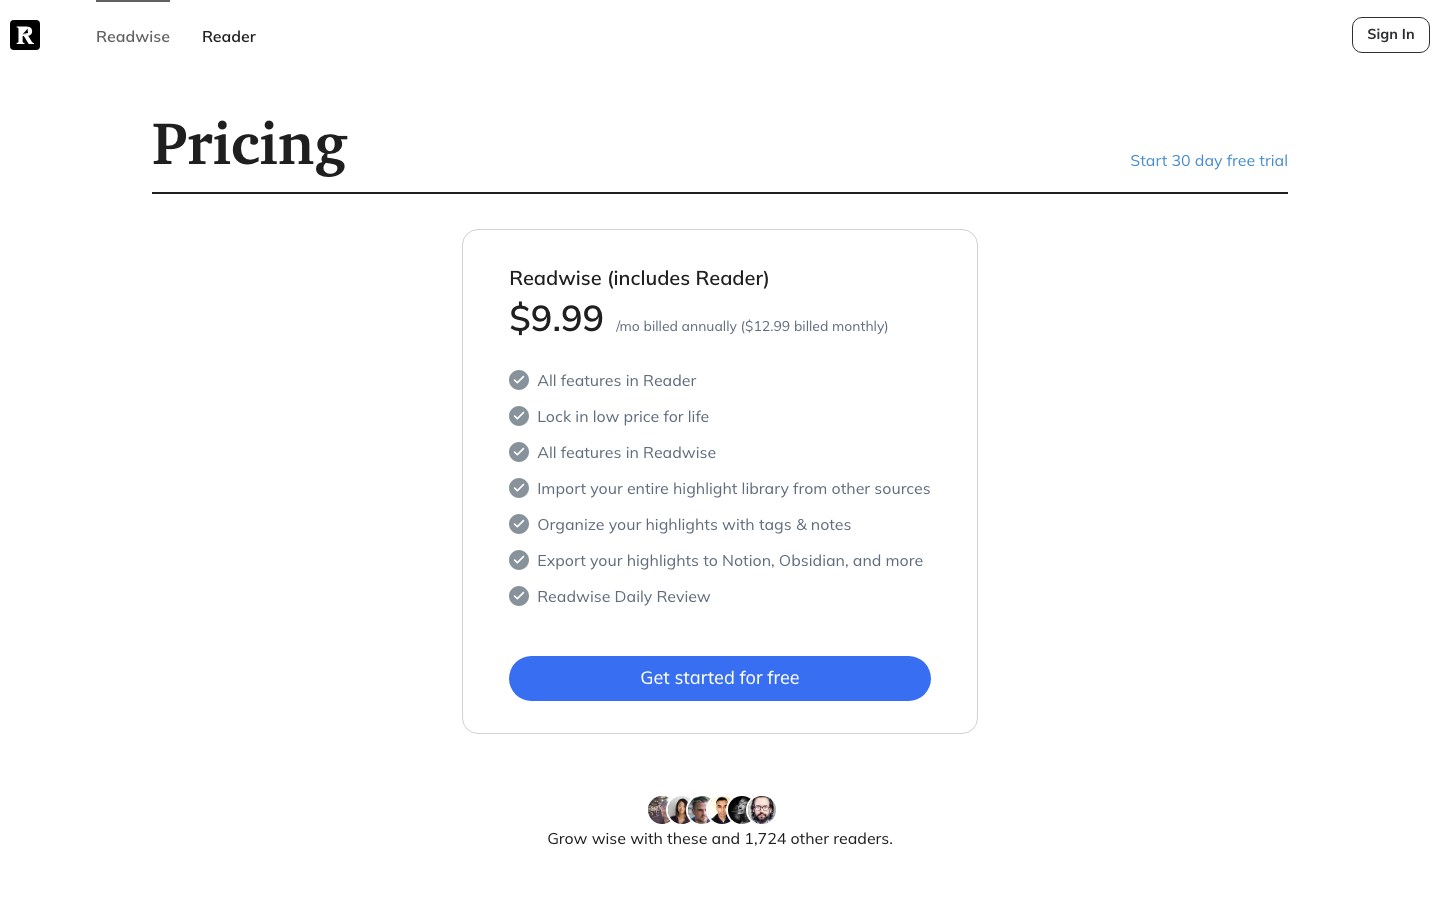
收费模型:Full plan 年付 $119.88($9.99/月)或月付 $12.99,Reader 与 Readwise 绑定;无永久免费层,只有试用。收入来自 recurring subscription,不依赖广告或内容授权。
CURRENT PUBLIC PRICING · Readwise pricing ↗
价格背后的成本与可持续性↗
高质量解析与 document snapshot、20TB+ Postgres、搜索/向量、sync/offline、多端客户端、LLM/BYOK 接口、support、导入迁移和 PKM integrations。最大成本可能是资深工程与长期 correctness,而不是每次摘要 token。
三个假设,以及怎样证明我们错了↗
以下不是一句‘值得做/不要做’的结论,而是三个可以被证伪的方向。任何一个 kill test 命中,都应停止为原叙事寻找借口。
把最重要的产品承诺放到失败路径里↗
一篇可变网页、一个 PDF、三处 highlights、一条 note;网页第二版删除其中一段并改变标题。
检查 snapshot、highlight location、re-import、Ghostreader prompt variables、Daily Review 与 export 文档;把 source v1 → saved document → source v2 → re-import 的状态分开。
公开文档支持保存 snapshot、稳定 highlight/note、review/export 和 prompt 读取 document/highlights;重新导入可能形成最新版与旧 annotation 之间的取舍。没有公开自动 diff 或把源站 v2 合并进同一 evidence lineage 的保证。
用户以为 library 永远代表‘最新网页’时,snapshot 保护证据反而造成版本错觉;强行覆盖又会破坏 highlight anchor。
Reader 选择 durable memory 而不是 continuous monitoring,这是一种正确边界。新的监控层应引用 snapshot ID,并把新版本作为 event,而非静默覆盖。
同一任务:Readwise Reader 与 Matter 的证据边界↗
保存一篇之后会被作者修改的技术文章,标注关键段落,三个月后找回原证据并导出到 Obsidian。
| Same job / public evidence | Readwise Reader | Matter | Decision boundary |
|---|---|---|---|
| 同一网页保存 | snapshot + highlight + note + review | read-later + highlight;review depth 较弱 | Reader 的价值在保存后的长期 loop |
| 源站改版 | 旧 evidence 可保留;自动 diff 不明确 | 通常保留解析副本;版本语义有限 | 两类工具都不是 change monitor |
| AI context | document/selection + programmable prompts | summary/chat 依产品而异 | Reader prompt runtime 更可组合 |
| 知识出口 | Readwise sync 到 Obsidian/Notion 等 | export/integration 较窄 | Reader 更像 knowledge substrate |
| 价格 | $119.88/年 full plan | 免费到较低价 premium | 只有持续 review/knowledge compounding 才能支撑溢价 |
深读基础设施,不是自动 intelligence team↗
Reader 不主动发现 weak signals,也不围绕 persistent query 生成团队级 market brief。Feed 文档默认不会自动摘要;批量自动处理需要用户提供 API key。它优化的是知识工作者的理解与记忆,而不是“不要读”。
Reader 为保护 highlight anchor 而保存旧 snapshot;monitoring 产品则希望页面一变就抓新版本并计算 diff。强行用同一个 document 覆盖会破坏引用,永不更新又会漏掉变化。值得做的新层应同时保存 immutable reading snapshot 与 version chain,再把 old/new 差异作为独立 event 交给用户。
干净、稳定、可离线的 document 是 AI 之前的基础设施↗
Browser extension、email forwarding、RSS、PDF、EPUB、video 与 social post 都需要不同 parser。Reader 保存原始版本以维持 highlight 和 note 的位置语境;这也意味着重新抓取更新版本不是无损操作。
一个 flat document database 上的 saved query↗
Filtered View 可以按 tag、author、domain、feed、status、长度等条件组合,并保存到 sidebar 或 Home。Feed 与 Library 又区分“可能要读”与“决定长期保存”,避免所有订阅内容自动污染知识库。
Filtered View 不复制内容,而是对同一 document database 保存查询条件。用户可以同时拥有“过去七天的 AI newsletter”“未读且超过二十分钟的文章”“某项目所有高亮 PDF”等交叉视图。产品需要显示查询解释、零结果原因与字段可用性,否则灵活语法也会变成只有 power user 会维护的隐性配置。
从研究论文到永久笔记,而不是一次 summary↗
研究者保存 PDF,先让 Ghostreader 提取结构和关键概念;阅读时高亮证据、添加自己的 note,再用自定义 prompt 只基于 highlights 生成反驳或问题。最后 highlight 与 note 同步到 Readwise Review 和 Obsidian/Notion,进入写作材料库。
Context scope 越清楚,回答越容易被信任↗
Document prompt、selection prompt 与 Quick Lookup 对应不同上下文和输出位置。Jinja-like variables、lexical search、most-similar 与 token control 让用户知道模型读了什么,也能避免把整个 library 模糊地塞进一次 chat。
Readwise 先解决“记住”,Reader 再接管“读什么和在哪里读”↗
Readwise 最初的核心是导入 Kindle 等来源的 highlights、Daily Review 与 PKM export。Reader 在 2022 年 public beta 把 capture 前移:article、newsletter、RSS、PDF、EPUB、video 和 social post 先进入统一阅读器,highlight 与 note 随后自然流入既有 review system。
Ghostreader 再把 LLM 插在 before/during/after reading 三个阶段,而不是另造一个独立 AI notebook。2026 年统一 Chat 与 Quick Lookup 继续减少调用摩擦,但输出仍能保存回 document/highlight context。
为了让 highlight 永久有效,Reader 宁愿保存旧版本↗
Reader 有意保存用户当时导入的 document version,使 highlight location、note 与引用不会因网页改版而漂移。官方 parsing FAQ 说明,要获得更新文章通常需要删除后重新保存,而这可能同时删除 annotations。
这是 deep-reading 产品正确但重要的 trade-off:它优先保存“我读过的证据”,而不是持续追踪“网页现在变成什么”。因此不能把 Reader 的 library history 当作 change monitoring。
一个 flat database,通过 saved query 形成不同工作台↗
Filtered View 可以按 author、domain、tag、feed、category/type、location、seen/status、reading length 等字段组合,还能用 AND/OR 和括号表达复合条件。View 可保存、pin、split 成不同状态 tabs,并放到 Home。
这个设计避免 Folder hierarchy 把 document 永久锁进单一路径。同一篇论文可以同时出现在“本周待读”“AI safety”“高亮超过 10 条”和“准备写作”视图中;查询本身就是 workflow,而不是静态目录。
Ghostreader 是有 scope、变量、subroutine 与 output location 的小型阅读语言↗
Document、paragraph/highlight、word/phrase 与 automatic prompt 对应不同 context。变量能读取 metadata、content、HTML、tags、notes、progress、highlights 与 selection;subroutine 提供 token count、truncate、central paragraphs、lexical search、semantic similarity、classification 与 range。
这使高级用户能写出“若 PDF 超过 25k tokens,先抽 central paragraphs;只基于我的 highlights 生成反驳;结果保存进 document note”这样的可复用程序。价值不在 prompt 文案本身,而在它与 durable objects 的连接。
它是 knowledge compounding system,不是自动 intelligence analyst↗
相对 Folo/Inoreader,Reader 对单个 document 的 parsing、annotation、offline 和 memory 更深,但 source monitoring 较弱。相对 Feedly,它没有 entity/event ontology 和自动 market report,却拥有用户亲自确认过的 highlights 与 notes。相对 chat-with-PDF 工具,它的防御力来自多年积累的 review/export loop,而不是一次问答。
Readwise 已占据“保存—标注—复习—导出”的个人知识闭环,再做通用 read-it-later 很难迁移它的历史数据与习惯。空白在于把用户的高质量判断反向用于未来监控:一次 highlight、note 或忽略不只存进 library,还可以更新某个 watch objective。产品随后主动寻找相似变化,但每次都解释是由哪条既有判断触发。
让 AI 产物进入 durable memory,而不是消失在 chat↗
Reader 的关键不是“和 PDF 聊天”,而是 response 能进入 document note、highlight note、review 与 export。用户修正过的理解会成为下一次工作流的资产,形成比模型本身更稳定的留存。
新的知识产品应区分三种记忆:原始证据必须不可变,用户解释可以被修订,外部事实则沿时间形成版本。很多工具把三者混成一段向量或一份最新文档,导致引用漂移、旧判断无法复盘。若能让用户从任一结论回到当时证据,并看到后来哪些事件推翻或加强它,就不再只是另一个阅读器或聊天框。
把深读 memory 接到持续变化监控↗
Reader 保存的是用户主动选择的 document memory;监控产品保存的是外部世界的 event memory。新方向可以连接两者:检测变化后生成可标注的证据包,让用户的 highlight、判断和 note 成为以后 relevance 与 impact scoring 的反馈。
Reader 的强项是让证据和个人判断长期不丢;新方向应把这份记忆变成可解释的未来监控,而不是复制阅读界面。